Is je AI-oplossing betrouwbaar? Zo valideer je hem zonder schijnzekerheid
Een praktisch validatiekader voor teams: van testset en scoremodel tot fail-criteria en continue kwaliteitschecks.

Een AI-oplossing lijkt vaak betrouwbaar zolang je demo’s draait met nette voorbeeldinput. De echte test begint pas op de werkvloer: rommelige data, tijdsdruk en uitzonderingen.
In dit artikel krijg je een praktisch validatiekader dat je in teams direct kunt gebruiken.
Wat bedoelen we met “AI-oplossing valideren”?
Valideren betekent: aantonen dat je oplossing niet alleen kan werken, maar consistent werkt binnen jouw context, risiconiveau en kwaliteitsnorm.
Dus niet: “de output ziet er meestal goed uit”, maar: “we weten wanneer het goed is, wanneer het fout gaat en wat we dan doen”.
De validatiepiramide (van basis naar betrouwbaarheid)
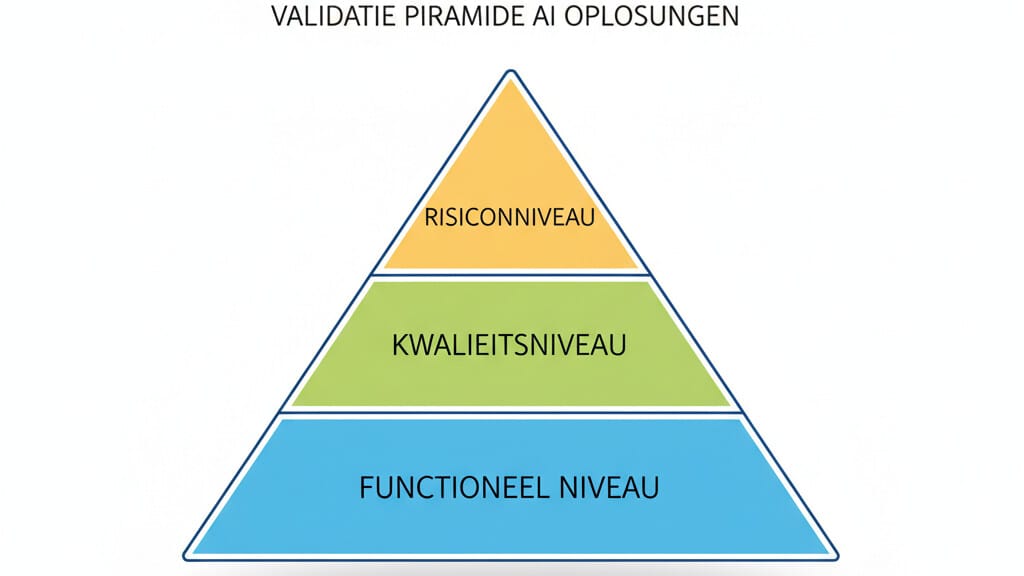
1) Functioneel niveau — werkt het technisch?
- Geeft het systeem output op de juiste input?
- Crashes, time-outs, en integratiefouten onder controle?
2) Kwaliteitsniveau — is de output bruikbaar?
- Juistheid (feitelijk correct)
- Volledigheid (mist er cruciale informatie?)
- Toepasbaarheid (kan een medewerker hier direct op handelen?)
3) Risiconiveau — is dit veilig genoeg?
- Wat is de impact van foute output?
- Wanneer is menselijke review verplicht?
- Welke fouten zijn “no-go”?
Praktisch 4-stappenplan voor teams
Stap 1 — Bouw een echte testset
Gebruik 30–50 cases uit de praktijk: standaardcases, randgevallen en bekende probleemcases. Geen synthetische “perfecte” voorbeelden.
Stap 2 — Definieer scoreregels
Werk met een vaste score per case (bijv. 1–5) op juistheid, volledigheid en risico. Zo voorkom je discussies op gevoel.
Stap 3 — Leg fail criteria vast
Voorbeeld: “Bij juridische of financiële output is elke feitelijke fout automatisch fail.” Zonder harde grens sluipt kwaliteitsverlies in je proces.
Stap 4 — Maak validatie doorlopend
Valideer opnieuw bij wijzigingen in prompts, model, contextdata of proces. AI-oplossingen driften mee met veranderingen in input en gebruik.
Snelle teamcheck (5 minuten)
- Hebben we een vaste testset met echte cases?
- Is er een scoremodel dat iedereen gebruikt?
- Is duidelijk wanneer output niet door mag?
- Is high-risk output altijd gekoppeld aan menselijke review?
- Loggen we wijzigingen en kwaliteitsimpact?
Waar het vaak misgaat
De grootste fout: teams verwarren “indrukwekkende output” met “betrouwbare output”. Een model dat 8 keer goed zit en 2 keer fout op kritieke cases is in productie vaak nog onacceptabel.
Wat dit oplevert als je het goed doet
- Minder herstelwerk na livegang
- Snellere besluitvorming over wel/niet opschalen
- Betere samenwerking tussen product, operations en compliance
- Meer vertrouwen in AI bij management én werkvloer
Interne verdieping
Conclusie
Een AI-oplossing valideren hoeft niet zwaar te zijn, maar wel systematisch. Als je test op echte cases, duidelijke fail-criteria en continue kwaliteitsloops, voorkom je dat een mooie demo eindigt in een fragiele productieoplossing.